AIセキュリティ診断の項目と範囲|LLMアプリ・AIエージェントで何を調べるか
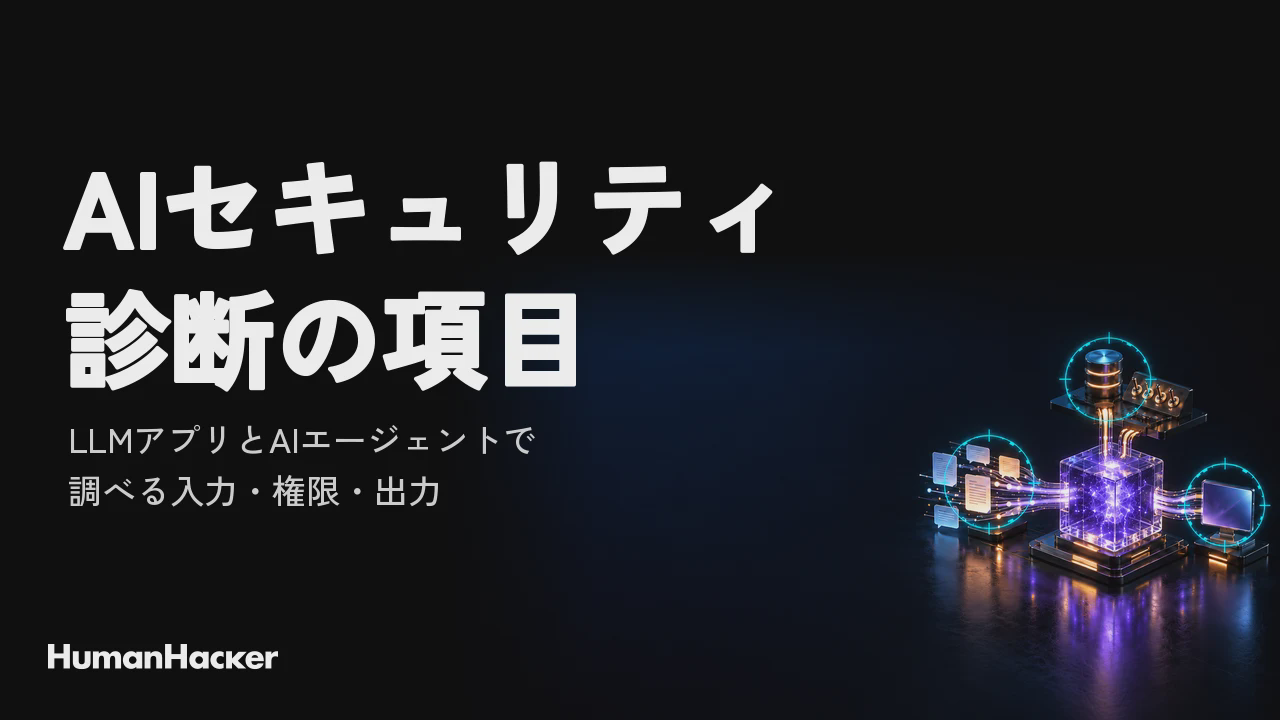
AIセキュリティ診断の項目は、通常のWeb診断の項目に、LLMへの入力、LLMが読めるデータと動かせる機能、出力の行き先の3か所を加えたものだ。
依頼する側は、誰が使い、何を読ませ、どの機能とつながり、何をさせたくないかを先に整理する。
AIセキュリティ診断の項目と通常の脆弱性診断との違い
AIセキュリティ診断は、通常の脆弱性診断の項目に、LLM(大規模言語モデル)を経由する影響の確認を重ねたものだ。AISI(AIセーフティ・インスティテュート)も『AIセーフティに関するレッドチーミング手法ガイド』で、従来の情報セキュリティの考え方の延長にAI固有の評価を重ねる必要があるとしている。
AIセキュリティ診断と通常の脆弱性診断の項目の違い
NISTは『敵対的機械学習:攻撃と緩和策の分類と用語』で、生成AIのモデルはデータと指示を同じ経路で受け取るため、攻撃者はシステムが読み込む資料を書き換えて動作に影響を与えられると説明している。通常の診断の主な項目は認証、アクセス制御、入力値の処理だ。範囲では、Web・APIの不備と、LLMを介した情報の持ち出しや意図しない操作を別の行に分ける。
AIレッドチームとセキュリティ診断の目的・評価項目の違い
AISIのガイドは、レッドチーミングを次のように定義している。
「攻撃者がどのようにAIシステムを攻撃するかの観点で、AIセーフティへの対応体制及び対策の有効性を確認する評価手法」
aisi.go.jpAISI「AIセーフティに関するレッドチーミング手法ガイド(第1.10版)」
決めた項目を一通り確かめ、項目ごとに弱点があるかを見たいならAIセキュリティ診断を、想定した攻撃に対策と対応体制が効くかを確かめたいならAIレッドチームを選ぶ。
AIセキュリティ診断の主要項目:LLMアプリの入力・権限・出力
主要項目は、OWASPの『LLMアプリケーションのTop 10 2025』の10項目のうち、範囲の軸になるLLM01・02・05・06に、LLM07とLLM10を加えた6つだと我々は考える。冒頭の図は、この6つを構成図の3か所に割り付けたものだ。
LLMのセキュリティ診断項目:プロンプトインジェクション
プロンプトインジェクションは、入力された文章によってLLMの動作や出力が意図しない形に変わる脆弱性だ(OWASP『LLM01:2025 プロンプトインジェクション』)。利用者がチャット欄に入力する直接型と、第三者が指示を埋め込んだWebページやファイルをLLMが読み込む間接型がある。NISTによれば、間接型を仕掛けるのは第三者で、被害を受けるのは多くの場合、正規の利用者だ。
診断では、チャット欄に加えて、LLMが読み込む外部の資料をすべて入力の経路として数える。評価の基準は、禁じた回答や利用者の権限外の情報が出力に出たかどうかだ。出力に出てはいけない情報には、OWASPが『LLM02:2025 機密情報の開示』で例に挙げる個人情報や認証情報、社外秘の業務データが入る。
システムプロンプトが引き出されたときに困る情報が入っていないかも確かめる。OWASPは『LLM07:2025 システムプロンプトの漏えい』で、システムプロンプトは秘密にできるものではなく、認証情報などを書くべきではないとし、問題は文面の漏えいより、認可の確認をLLMに任せていることにあると説明している。
AIエージェントのセキュリティ診断項目:操作・参照権限
OWASPは『LLM06:2025 過剰な権限』で、原因を3つに分けてメール要約用のアシスタントの例を挙げている。要約には読み取りだけで足りるのに、選んだ拡張機能は送信もできた。そこへ間接型のインジェクションを仕込んだメールが届くと、アシスタントが受信箱の機密情報を攻撃者へ送ってしまう。
診断の項目は、エージェントが呼べる機能と、その機能が使うアカウントの権限を一覧にし、業務に要る範囲と比べることだ。全利用者のファイルを読める共有の特権アカウントで接続していないか、送信や削除の前に人の承認が入るかも確かめる。
LLMのセキュリティ診断項目:出力の利用先と検証
出力の不適切な処理(LLM05)は、LLMの出力を検証・無害化しないまま次の部品やシステムへ渡す不備を指す。行き先ごとに、通常の診断と同じ観点で試す。画面に表示するならXSS・CSRF、データベースへの保存ならSQLインジェクション、コードやコマンドの実行ならリモートコード実行、バックエンドの処理ならSSRFや権限昇格につながりうる。
評価の基準は、LLMの出力を、利用者の入力と同じく信用しない値として扱っているかだ。
LLMのセキュリティ診断項目:利用回数と費用の上限
OWASPは『LLM10:2025 無制限の消費』で、推論を制限なく実行できる状態を挙げ、従量課金のAIサービスに大量の処理をさせて提供側に費用を負わせる攻撃も例に入れている。
診断では、入力の長さ、利用者ごとの回数、1回の処理時間に上限が効いているかを確かめる。上限が効かないと、サービスの停止、金銭的な損失、モデルの複製につながりうる。
AISIのガイドは、回数に制限のある商用サービスへ大量のクエリを送る試験は避けるよう求めている。どこまで負荷をかけるかは試験の前に決める。
AIセキュリティ診断の項目に合わせた試験条件:チャットボット・AIエージェント
試験条件では、成功と判断する基準と試行回数を、試験の前に依頼先と書面で決める。AISIのガイドは、LLMは同じ入力に同じ出力を返すとは限らず、一度失敗した攻撃が後で成功することもあるとして、条件と結果のログを取ることも勧めている。
利用者の権限と試験データの条件
チャットボットでは、社外の顧客、社員、管理者など利用者の種類ごとに読めるデータの範囲を決め、種類ごとに診断用のアカウントを用意する。
試験データには、本番の個人情報の代わりに目印を入れた試験用の文書を置くとよいと我々は考える。AISIのガイドは、実運用環境では品質の低下や検知の仕組みへの影響が、ステージング環境や開発環境では実運用との結果のずれが起こりうるとしている。
AIエージェントの接続先・操作と停止の条件
メール送信やデータ更新をするエージェントでは、試験中の操作が実際に外部へ届く。操作が届く範囲を試験の前に決める。送信先は試験用のアドレスに、更新は試験用のデータに限る。
想定外の操作が起きたときに止めるか続けるかの基準と復旧の手順、重大な脆弱性を報告書を待たずに共有するかも、AISIのガイドに沿って先に取り決める。どの入力でどの機能を呼んだかを残せば、承認が入るべき操作で入ったかを後から確かめられる。
AIセキュリティ診断の依頼前に整理する項目:構成図・評価基準
依頼前に整理するのは、構成図に書き込む、どこから入り、何を読み、何を動かし、どこへ出すかと、依頼先と決める成功・失敗の基準だ。
- 使っているLLM:外部のAPIか、自社で動かすモデルか
- させたくない操作:外部への送信、削除、支払いなど
- 失敗とみなす出力:権限外の文書の内容、システムプロンプト、認証情報
- 失敗とみなす操作:承認なしの外部送信や削除
- 確認の深さ:成功の可能性を示すまでか、実際に成功させるまでか
- 渡す情報:システムプロンプト、構成、権限の設定
AISIのガイドは、診断する側に渡す内部の情報の量で試験を3つに分けている。ブラックボックスは内部の情報を渡さず、攻撃者の目線に最も近い。グレーボックスは内部構造などの一部を、ホワイトボックスは内部の情報を渡し、より多くの対策の効き目を確かめられる。商用LLMの部分は基本的にブラックボックスでしか試せないので、部品ごとに、どこまで情報を渡すかを決める。
同じガイドは、外部のLLMを提供元が試験していてもAIシステム全体の安全を確かめたことにはならないこと、自然言語の入力は網羅的な試験が難しいこと、試した攻撃が成功しなかったことはすべての攻撃が成功しないことを意味しないことも明記している。
運用開始後も、システムプロンプトの変更や対策の追加・修正などに合わせて定期的または必要に応じて実施するよう、AISIのガイドは勧めている。LLMの差し替えや、データ・機能の追加も見直す時期だと我々は考える。
よくある質問
通常の脆弱性診断を受けていれば、AIセキュリティ診断の項目は確かめなくていい?
LLMを組み込んだシステムなら確かめる。通常の診断の主な項目は認証、アクセス制御、入力値の処理だ。LLMを経由した情報の持ち出しや意図しない操作は、範囲表で別の行に書いて確かめる。
外部のLLMを使っているだけでも、診断は必要?
必要だ。AISIのガイドは、提供元がLLMを試験していてもAIシステム全体の安全を確かめたことにはならないとしている。自社がLLMに読ませるデータ、呼ばせる機能、出力の行き先を範囲に入れる。
AIセキュリティ診断は、いつやり直せばいい?
AISIのガイドは、運用開始後もシステムプロンプトの変更や対策の追加・修正に合わせて実施するよう勧めている。我々は、LLMの差し替えや、読ませるデータ・呼べる機能の追加も見直す時期だと考える。